

Nuestra visión
Cada flota debería aprender de su propia experiencia.
Construimos infraestructura de fleet learning: el sistema que ayuda a un equipo de Physical AI a decidir qué debe aprender su modelo a continuación, desarrollar los datos adecuados del mundo físico (datos 4D de cada sensor, a lo largo del tiempo) y medir qué cambió. Desde un primer conjunto de demostraciones grabadas hasta una flota en producción, un equipo debería poder desarrollar su propia inteligencia sin reconstruir toda la operación de datos que hay detrás, y sin alquilársela a otro.
Fleet Learning Infrastructure para Physical AI
 Emal AlwisFundador y CEO
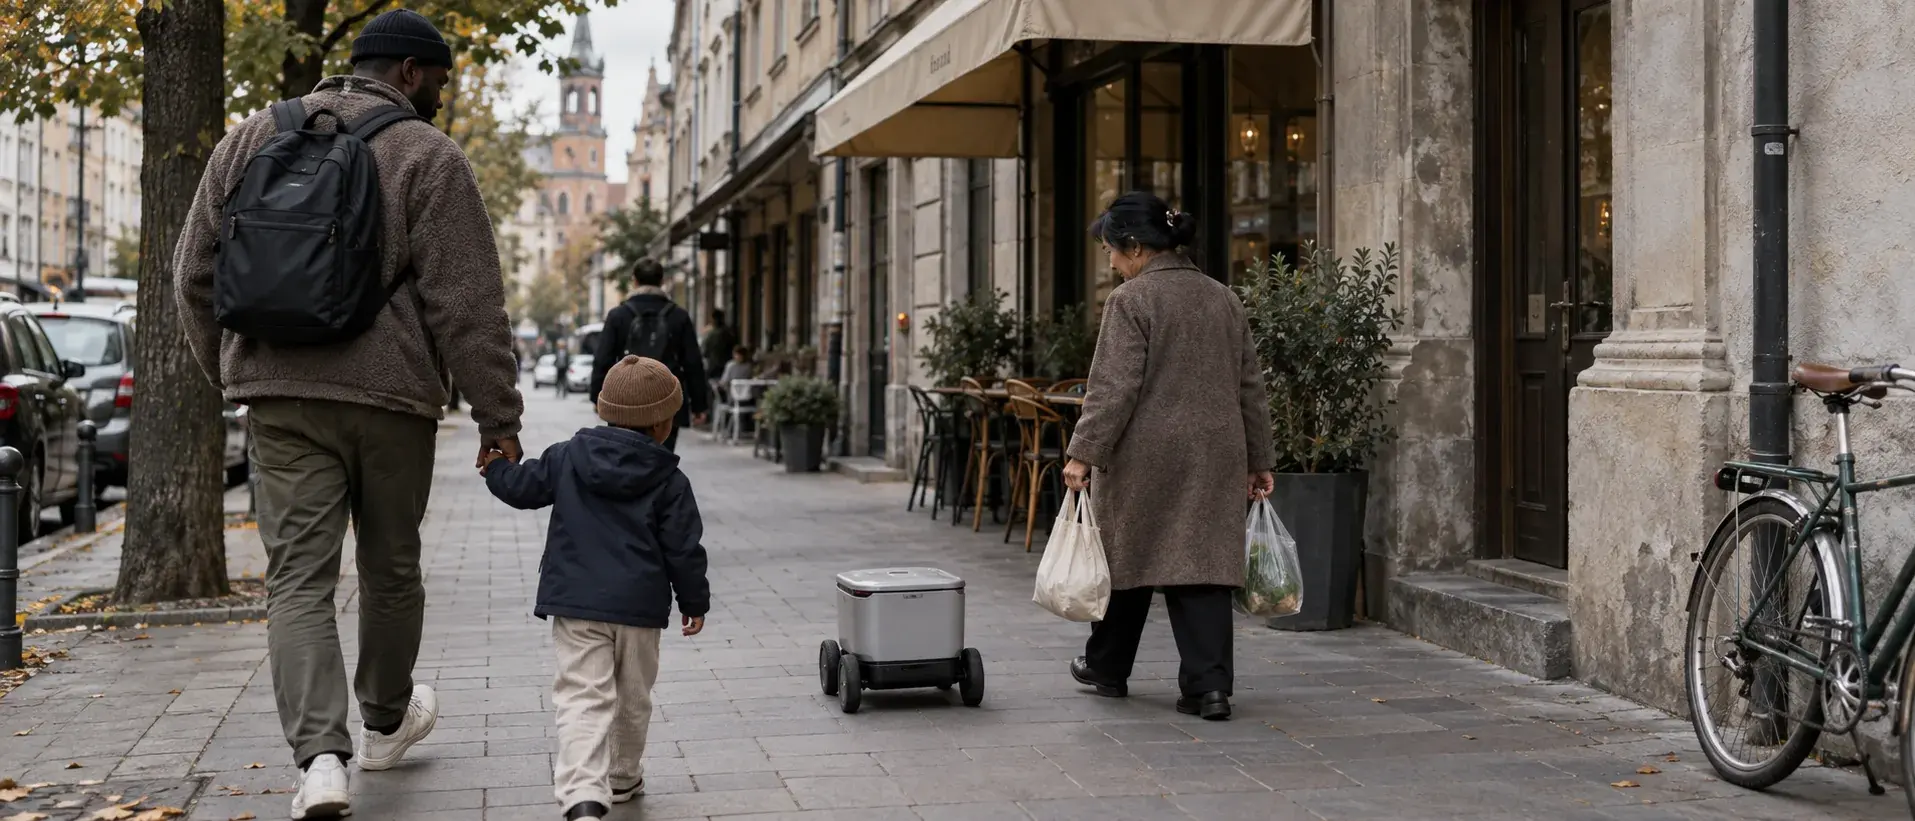
El sentido de una máquina que aprende es que la vida sea más fácil: un trabajo más seguro, cuidados que cuestan menos, comida que llega a más personas. Esa es la medida hacia la que construimos.
La oportunidad
Una experiencia debería convertirse en una mejora.
Imagina un vehículo que se acerca a una zona de obras que cambió de la noche a la mañana. A su modelo le cuesta interpretar la nueva distribución. La grabación debería convertirse en algo más que un archivo de registro o una investigación puntual. Con el contexto adecuado, puede ayudar al equipo a entender el fallo, preparar mejores datos de entrenamiento y comprobar si el siguiente modelo resuelve esa situación con mayor fiabilidad.
Ese es el futuro que queremos para las máquinas autónomas: experiencia que se convierte en aprendizaje útil, una y otra vez, desde las primeras demostraciones que graba un equipo hasta las flotas que llegue a operar. Un robot de reparto, una cosechadora y un brazo industrial se enfrentan a problemas distintos. Quienes los construyen comparten la necesidad de conectar lo que sucede en el mundo con lo que cambia en el modelo. Queremos que esa conexión se convierta en infraestructura fiable.
La perspectiva del fundador
El modelo es una parte. El ciclo es la ventaja.
En Tesla Autopilot fui el primer ingeniero en trabajar en fleet learning: los sistemas que convertían los casos límite de la flota en mejoras del modelo. Ese trabajo me enseñó a mirar más allá del modelo: cómo el equipo encuentra ejemplos útiles, conserva el contexto de los sensores, decide qué ocurrió y convierte esas decisiones en el siguiente conjunto de entrenamiento. La capacidad de repetir ese proceso importa tanto como cualquier avance individual.
Fundé Avala porque otros equipos de Physical AI no deberían tener que construir toda esa base desde cero. Deberían poder dedicar lo mejor de su ingeniería a las máquinas y los modelos que los distinguen. Avala debería ofrecerles una forma fiable de aprender del mundo, desde su primer flujo de trabajo en producción hasta las flotas que lleguen a operar.
Dónde nos situamos
Cinco capas. El modelo del cliente es una de ellas. Avala es la capa justo debajo.
El stack de IA tiene cinco capas, desde la máquina en acción hasta la electricidad que la alimenta. Los datos no son una capa propia. Viven en la capa de modelos, como activo del cliente, porque son aquello de lo que aprende el modelo. La infraestructura es aquello sobre lo que un modelo se construye, se mejora y se ejecuta: todo lo relacionado con los datos que lo crean, y el cómputo que hay debajo.
Aplicaciones
Lo que una máquina hace por alguien: el robot, el vehículo, el dron en acción.
Modelos
El cerebro y lo que le enseña: el modelo del cliente y los datos del cliente. La evaluación y el post-entrenamiento ocurren aquí, en el cómputo del propio cliente.
Infraestructura
Aquello sobre lo que los modelos se construyen, se mejoran y se ejecutan: todo lo relacionado con los datos que los crean, desde la recopilación hasta la publicación verificada, y las herramientas, el cómputo y la nube que hay debajo.
Avala está aquíSemiconductores
El silicio.
Energía
La electricidad que pone límite a todo lo demás.
Avala está en la capa de infraestructura, justo debajo del modelo del cliente. No construimos robots, no poseemos el modelo del cliente, no vendemos cómputo ni fabricamos chips. Construimos la infraestructura de datos y aprendizaje mediante la cual el propio modelo del cliente aprende de su propia flota.
El siguiente dataset
El siguiente dataset debería responder a una pregunta.
Una máquina puede fallar porque no se ha encontrado con una situación, porque su supervisión es inconsistente o porque el problema está en otro lugar distinto de sus datos de entrenamiento. La primera tarea es entender la brecha.
Nuestra visión es un sistema que conecta un objetivo de aprendizaje con un plan de datos explícito: qué experiencia existente usar, qué experiencia nueva adquirir, cómo cualificarla y qué experimento establecerá si ayudó. La cobertura amplia y el aprendizaje dirigido van juntos. El objetivo no es simplemente un dataset más grande. Es una decisión mejor fundamentada sobre qué hacer a continuación.
Esa disciplina funciona en ambos sentidos. A veces la intervención correcta es reparar una calibración, cambiar una política de anotación ambigua o reequilibrar los datos que un equipo ya tiene. Un socio de datos creíble debería decirle a veces a un cliente que no compre más datos.
Capacidad verificada
La unidad de progreso es una capacidad verificada.
Un dataset es evidencia, no el objetivo. Para cada objetivo de aprendizaje conservamos la capacidad que se pone a prueba, las situaciones que la ejercitan, la evidencia usada para entrenarla, el criterio usado para evaluarla y el resultado.
Eso hace que un programa de aprendizaje sea reproducible. La misma capacidad puede probarse frente a una nueva versión de datos, un nuevo modelo o un nuevo runtime sin reconstruir el razonamiento que la produjo. Con el tiempo, esas capacidades versionadas se convierten en el historial operativo de cómo aprendió una máquina.
Dos ciclos de aprendizaje
Dos sistemas deberían mejorar.
El modelo del cliente debería tener un camino más claro desde un fallo observado hasta una mejora probada. El sistema que desarrolla sus datos debería volverse más capaz con cada programa. La evidencia que conecta ambos es lo que se acumula.
Un método mejor debería dejar evidencia tras de sí. Cuando una nueva comprobación, instrucción, política de enrutamiento o modelo especializado parece mejorar el proceso, lo tratamos como una hipótesis. Lo comparamos con el método anterior, medimos calidad y coste sobre evidencia reservada, registramos el resultado y conservamos la posibilidad de revertirlo. El sistema debería recordar no solo qué funcionó, sino también qué se probó, qué falló y en qué condiciones.
La máquina del cliente aprende
Definir la capacidad
Nombra lo que el modelo debe hacer y cuál es su rendimiento actual.
Seleccionar o adquirir evidencia
Encuentra experiencia existente útil. Recopila solo lo que falta.
Preparar una versión
Fija las grabaciones, las etiquetas, la procedencia y la evidencia de calidad.
Entrenar y evaluar
El cliente entrena en su propia infraestructura de cómputo y puntúa el modelo según un criterio acordado.
Elegir la siguiente intervención
Más datos, una política corregida, un conjunto reequilibrado o un problema que está fuera de los datos.
Avala aprende a desarrollar mejores datos
Observar errores de producción
Defectos de captura no detectados, identidad de objetos inconsistente, enrutamiento de revisión ambiguo.
Resolver desacuerdos
Cuando los expertos discrepan, decide y registra por qué.
Mejorar una herramienta o una política
Una mejor comprobación, una instrucción más clara, una mejor ayuda para el siguiente revisor.
Validarlo de forma independiente
Mide calidad y coste juntos. Una revisión más rápida que pasa por alto más defectos no es una mejora.
Aplicarlo a la siguiente versión
Métodos más sólidos, criterios más claros y evidencia para la siguiente decisión.
El ciclo de aprendizaje de flota
En la práctica, el ciclo avanza en siete etapas. Avala ejecuta cinco de ellas. Usted entrena el modelo y decide cuándo se lanza.
Observar
A cargo de Avala
Diagnosticar
A cargo de Avala
Evaluar
A cargo de Avala
Adquirir
A cargo de Avala
Entrenar
A cargo de usted
Validar
A cargo de Avala
Publicar
A cargo de usted
Contexto físico
El contexto físico forma parte de la supervisión.
Un ejemplo útil del mundo físico es más que la imagen de un objeto. La tarea puede depender de lo que ocurrió antes, de lo que intentó la máquina o la persona y de lo que ocurrió después. Conectamos las observaciones de los sensores con el contexto disponible para la tarea: tiempos, geometría, trayectorias, acciones cuando se registraron, resultados e interpretación humana.
Ese contexto sigue siendo inspeccionable durante la recopilación, la revisión, la preparación del dataset y la evaluación. La información que falta o es incierta queda visible, no oculta detrás de una etiqueta completada. Una escena 4D reconstruida preserva el contexto físico para que pueda inspeccionarse; no sustituye a las acciones medidas, el contacto o la validación cuando una tarea los requiere.
La base actual
Empieza donde falla el proceso de aprendizaje.
Nuestro trabajo empieza con los datos de producción de una flota: grabaciones de sensores multimodales reconstruidas en datos 4D, etiquetadas por IA y revisores expertos, y publicadas como datasets versionados con los que entrena el cliente. Las grabaciones MCAP y ROS, las imágenes de cámara, el LiDAR y las trayectorias de robots deben permanecer conectados al contexto que los hace útiles. Combinamos software y operaciones expertas para preparar datos que cumplan los requisitos de entrenamiento del cliente.
Empieza con un problema recurrente: etiquetas inconsistentes, ejemplos que faltan o un conjunto de entrenamiento que necesita otra ronda de correcciones. Define qué significa aceptable. Mide los plazos, la calidad y el esfuerzo total. Después, facilita la producción de la siguiente versión. Así es como un proyecto concreto de datos puede convertirse en un sistema en el que el cliente confía, en lugar de otra entrega desconectada.
Explora la plataformaEvidencia
Unos datos mejores deben demostrarse.
Superar una comprobación de calidad no demuestra, por sí solo, que un modelo mejoró. Cada programa mantiene separadas tres preguntas, porque cada una necesita evidencia distinta y ninguna resuelve las otras dos.
¿Cumplieron los datos su especificación?
Cobertura, calidad y procedencia, comprobadas frente al plan con el que empezó el programa.
¿Se volvió más eficaz producirlos?
Plazos, retrabajo, esfuerzo de revisión y defectos no detectados, medidos frente al ciclo anterior.
¿Rindió mejor el modelo?
Puntuado con una evaluación acordada frente a una línea base, incluido lo que no mejoró.
Contratamos por la cobertura y la evidencia que podemos verificar. Si la próxima versión mejora tu modelo se establece mediante un experimento que tú ejecutas, no se promete por adelantado. Los clientes mantienen la autoridad sobre sus modelos, sus decisiones de entrenamiento, sus criterios de evaluación y su despliegue.
La próxima década
Dueños de su propia inteligencia, no inquilinos de la de otros.
En 2028, Avala es la infraestructura abierta sobre la que cualquier operador de máquinas en el mundo físico convierte su propia experiencia en su propia inteligencia, con datos, modelos y despliegue bajo su propio control, para que todos puedan ser dueños de su inteligencia y no inquilinos de la de otros. Queremos ganarnos esa posición en cuatro fases conectadas.
Demostrar el valor de un flujo de trabajo en producción.
Resolver un problema que un cliente necesita resolver ahora. Entregar según un criterio de aceptación claro y medir el resultado frente al proceso anterior. Hacer más fiable el siguiente ciclo, sin conformarse con que la primera entrega impresione.
Convertirnos en la base para todos los modelos y equipos.
Llevar la misma identidad del dataset, el historial de revisión y las políticas de calidad a más flujos de trabajo. Cada ampliación debería reutilizar la infraestructura ya existente. La prueba es si otro equipo o modelo puede beneficiarse sin necesitar otro proyecto de ingeniería a medida.
Automatizar la investigación entre el descubrimiento y la mejora.
Avanzar hacia agentes de investigación capaces de investigar un fallo de la flota, recuperar la evidencia, compararla con casos anteriores, proponer un experimento, encontrar o encargar los ejemplos que faltan y evaluar el resultado. Sus conclusiones siguen siendo trazables hasta la evidencia física, sus evaluadores se prueban frente a criterios ocultos y los cambios de mayor impacto siguen siendo revisables y reversibles. El objetivo no es un agente que produzca más datos. Es un sistema que mejora al decidir qué experimento merece la pena ejecutar a continuación.
Hacer que el aprendizaje sea portable en todo el ecosistema.
Conectar sistemas robóticos, modelos e infraestructura mediante interfaces abiertas. Los equipos deberían poder adoptar mejores herramientas sin renunciar a su historial. Los datasets y modelos compartidos pueden ampliar esa base cuando sus propietarios deciden compartirlos y su reutilización está permitida. La interoperabilidad debería ampliar el acceso, sin exigir que se ceda el control.
Ya existe experiencia útil del mundo físico, pero es incompleta, tiene una cobertura desigual y está en su mayoría desconectada de las decisiones que mejorarían un modelo concreto. La experiencia que más importa se sigue produciendo despliegue a despliegue, por las empresas dueñas de las máquinas, y son sobre todo excepciones: las situaciones que nadie simuló. Ninguna empresa la tendrá toda. Por eso la infraestructura que la encuentra, la cualifica, la combina y la complementa tiene que ser independiente, y por eso debe dejar la propiedad donde nacieron los datos.
En qué creemos
El progreso debería ampliar las oportunidades.
Los clientes deberían conservar la ventaja que les da su propiedad intelectual. Aprender de la experiencia de una flota no debe significar mezclar sus datos con los de un competidor sin que lo sepa. Las grabaciones, anotaciones, resultados de evaluación y modelos de un cliente nunca se convierten en la ventaja de otro cliente sin el acuerdo explícito de ese cliente. Un dataset compartido se comparte por acuerdo y su reutilización queda explícita. Abierto significa algo concreto para nosotros: interfaces interoperables, datos e historial exportables, derechos de uso claros y despliegue controlado por el cliente. Independencia significa que tu socio de infraestructura no pertenece a un laboratorio de modelos, a un fabricante de robots ni a un hiperescalador. Avala debería ganarse su lugar por el valor del sistema, no por la dificultad de dejar de usarlo.
Las personas que enseñan a las máquinas y las evalúan aportan más que capacidad de anotación. Definen tareas, reconocen errores significativos, juzgan resultados y fijan los criterios con los que se ponen a prueba los sistemas automatizados. Su criterio merece buenas herramientas, una remuneración justa y vías de acceso a trabajos más cualificados. Queremos que la automatización elimine el esfuerzo repetitivo y dé más valor a la experiencia: mejores decisiones registradas en el proceso, mejor software para apoyar la siguiente tarea y menos errores que se repitan.
El propósito más amplio es un trabajo físico más seguro y productivo, y servicios útiles que más personas puedan permitirse. Queremos que un pequeño equipo de robótica pueda apoyarse en capacidades que, de otro modo, exigirían una gran organización interna. Mejores máquinas son el medio. Que más personas puedan construir, obtener ingresos y beneficiarse de ellas es el objetivo.
Beneficioso por diseño
Máquinas al servicio de las personas, por diseño.
Physical AI cambiará qué es el trabajo, quién puede permitirse cuidados y cómo se transportan los bienes y los alimentos. Queremos que ese cambio sea bueno para las personas de una forma que pueda comprobarse, no darse por supuesta. Cuatro compromisos definen cómo construimos.
Las personas que enseñan a las máquinas reciben pago y formación para hacerlo.
Los coworkers de Avala cobran por el trabajo aceptado, a tarifas por encima de lo habitual para el trabajo y el lugar, con la formación integrada. La automatización elimina la repetición; el criterio cualificado se queda con las personas.
Quien es dueño de la máquina es dueño del modelo.
Los datos de flota de una empresa y la inteligencia aprendida a partir de ellos permanecen bajo su control, en formatos abiertos que puede llevarse si se va. Ningún laboratorio, fabricante de robots ni nube se interpone entre un equipo y su propia experiencia.
Se mide antes de confiar en ella.
Cada versión se puntúa frente a una línea base que fija el cliente, incluido lo que no mejoró. Una máquina se gana un uso más amplio con evidencia, evaluación a evaluación.
Los equipos pequeños obtienen capacidades de gran empresa.
Un equipo de robótica de diez personas debería poder aprender del mundo como lo hace una flota de miles. Si se reduce el coste de ese ciclo, más personas podrán construir mejores máquinas, obtener ingresos con ellas y beneficiarse de ellas.
Construye con nosotros
Empieza con un objetivo de aprendizaje.
Nuestra ambición a largo plazo es hacer del aprendizaje disciplinado a partir de la experiencia del mundo físico una infraestructura estándar, no una capacidad que solo unas pocas empresas pueden permitirse construir. Queremos ganarnos esa posición un flujo de trabajo demostrado tras otro: versiones de datos fiables, adquisición de datos mejor informada, herramientas especializadas validadas y una coordinación cada vez más automatizada bajo control humano. Tráenos una capacidad que tu modelo necesite aprender. Define qué significa el éxito. Construye el siguiente programa de datos en torno a esa capacidad.
El ensayo que desarrolla esta visión con más detalle.